Embeddings: como IA transforma sites e fotos em números
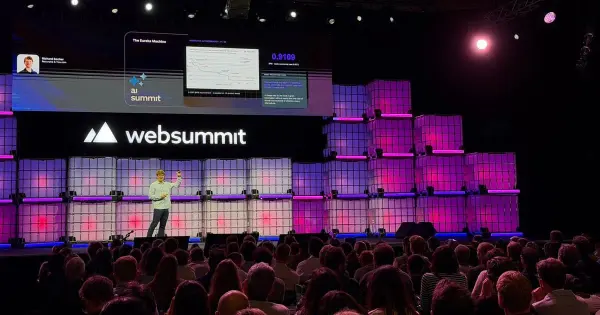
No Web Summit Lisboa, Alexey Milovidov mostrou como embeddings ajudam a converter textos, imagens e sites em vetores numéricos para busca e classificação. Segundo o portal Central do Varejo, a demonstração usou modelos abertos e grandes volumes de dados reais.
 Por Zainner Camilo
Em resumo
No Web Summit Lisboa, Alexey Milovidov, cofundador e CTO da ClickHouse, mostrou como embeddings transformam textos, imagens e sites em vetores numéricos para busca e classificação. Segundo o portal Central do Varejo, ele testou 22 modelos abertos em 150 milhões de exemplos para demonstrar usos práticos dessa técnica.
No Web Summit Lisboa, Alexey Milovidov, cofundador e CTO da ClickHouse, mostrou como embeddings transformam textos, imagens e sites em números para apoiar busca e classificação de dados. Segundo o portal Central do Varejo, a apresentação aconteceu nesta terça-feira, 10 de novembro de 2026, e reuniu exemplos práticos de como a IA organiza informações em vetores numéricos.
O que são embeddings e por que eles importam
Embeddings são representações numéricas que ajudam sistemas de IA a enxergar semelhanças entre conteúdos. Na prática, eles convertem texto, imagem ou outro tipo de dado em vetores que podem ser comparados, indexados e usados em tarefas como busca, classificação e recuperação de informação.
Milovidov explicou que existem diferentes definições para o termo, mas o uso que mais interessa é o de um modelo treinado para uma tarefa específica. Isso pode incluir, por exemplo, medir a similaridade entre textos e imagens ou encontrar a resposta mais relevante para uma pergunta.
Segundo o Central do Varejo, ele também apresentou uma versão sem modelo de linguagem, chamada de embedding esparso. Nesse formato, o texto é dividido em palavras, cada uma passa por um hash, e o vetor registra quantas vezes cada hash aparece. O processo pode ser descrito em poucas linhas de SQL.
Como a demonstração foi montada
Na sessão “How AI sees the world”, Milovidov disse ter rodado 22 modelos abertos sobre 150 milhões de exemplos reais para entender o que esses números revelam. A demonstração incluiu um site em que conjuntos de dados apareciam como galáxias navegáveis, com zoom e modo 3D.
Entre os conjuntos exibidos estavam:
- fotos de gatos agrupadas em aglomerados;
- comentários do Hacker News;
- capturas de tela de sites, reunidas em um conjunto que ele chamou de “a internet”.
De acordo com o portal Central do Varejo, ele usou 100 milhões de fotos e 40 milhões de comentários. No caso dos sites, criou uma coleção própria com 18 milhões de páginas, baixadas com 1.000 funções AWS Lambda ao longo de uma a duas semanas.
A base foi estruturada em uma tabela com uma coluna JSON, reunindo atributos de HTML, CSS, cookies, scripts e imagens. A ideia, segundo ele, era reunir metadados suficientes para entender como a internet funciona.
Modelos, custo e escala de processamento
Milovidov afirmou que existem centenas de modelos de embeddings e que selecionou vários deles, incluindo modelos de pesos abertos com até 8 bilhões de parâmetros. Ele disse que os vetores podem ser calculados em GPUs de uma instância g6.12xlarge da AWS, com custo de algumas centenas de dólares, ou por APIs de modelos e pelo OpenRouter.
Esse ponto é relevante para empresas que querem usar IA sem necessariamente construir tudo do zero. O custo e a escala de processamento são fatores centrais quando o objetivo é trabalhar com grandes volumes de dados e extrair sinais úteis para negócio.
Onde embeddings entram em busca e classificação
Milovidov resumiu o potencial da técnica com uma frase curta: “O que você pode fazer pelos embeddings?”. A ideia, segundo ele, é pensar em aplicações práticas, como:
- busca semântica;
- classificação de conteúdos;
- mapeamento de um espaço para outro;
- recuperação da resposta mais relevante para uma pergunta.
Um dos exemplos apresentados foi o uso de uma regressão logística pequena para análise de sentimento em comentários do Hacker News sobre o Google, a partir de um índice pré-calculado. Segundo ele, o processamento chega a centenas de milhões de registros por segundo.
Em outro caso, ele aplicou o método a textos sobre Elon Musk, agrupando os conteúdos em temas como sociedade e política.
O que isso mostra para negócios digitais
A demonstração reforça uma tendência importante para quem trabalha com dados, varejo digital e produtos baseados em informação: embeddings ajudam a transformar conteúdo não estruturado em algo que pode ser consultado e comparado com mais eficiência.
Na prática, isso pode apoiar sistemas que precisam lidar com grandes volumes de texto, imagem ou páginas web, especialmente quando a busca tradicional por palavras não basta. O ponto central não é apenas armazenar dados, mas criar uma forma de encontrar relações entre eles.
Para empresas, isso abre espaço para aplicações como:
- organização inteligente de bases de conteúdo;
- buscas mais relevantes;
- classificação automática de documentos e páginas;
- análise de temas em larga escala;
- comparação entre diferentes tipos de mídia.
Similaridade entre vetores e leitura dos dados
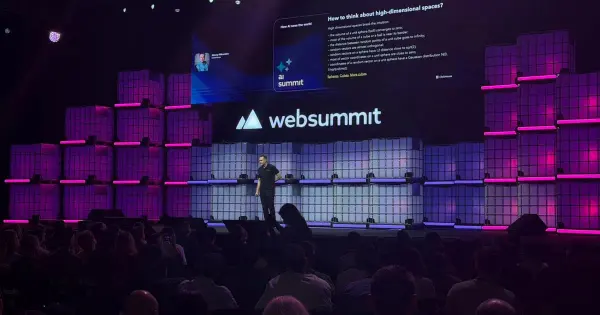
Outro ponto destacado por Milovidov foi a forma de comparar vetores. Ele citou distâncias como a euclidiana, chamada de L2, e a do cosseno. Segundo ele, quando os vetores são normalizados, a escolha da distância altera pouco o resultado.
Ele também observou que, em espaços com muitas dimensões, vetores aleatórios tendem a ser ortogonais, ou seja, têm pouco em comum entre si. Esse tipo de comportamento ajuda a entender por que embeddings funcionam bem para separar e aproximar conteúdos de acordo com padrões aprendidos pelo modelo.
Perguntas frequentes sobre embeddings
O que são embeddings em IA?
Embeddings são representações numéricas de textos, imagens ou outros dados. Eles permitem que sistemas de IA comparem conteúdos e identifiquem semelhanças com mais facilidade.
Para que embeddings servem na prática?
Eles servem para busca, classificação, recuperação de respostas e comparação de conteúdos. Também ajudam a organizar grandes volumes de dados não estruturados.
O que foi mostrado por Alexey Milovidov no Web Summit Lisboa?
Segundo o portal Central do Varejo, ele mostrou como modelos de IA transformam textos, imagens e sites em vetores numéricos, usando 22 modelos abertos e 150 milhões de exemplos reais.
A cobertura segue no Web Summit Lisboa
O Web Summit Lisboa segue até quinta-feira, 12, na MEO Arena e nos pavilhões da FIL. A apresentação de Milovidov ajuda a entender por que embeddings se tornaram uma peça importante na evolução de sistemas de busca e análise de dados.
Para quem acompanha inovação, o recado é claro: a IA não apenas gera conteúdo, ela também reorganiza informação em estruturas numéricas que podem ser consultadas, comparadas e classificadas em escala.