Treinamento de IA: até onde empresas vão para obter dados
A escassez de dados de qualidade leva empresas a usar fontes piratas e trabalho humano intenso para treinar modelos de IA, levantando questões éticas e legais.
 Por Ryc Santana
Em resumo
Empresas de tecnologia recorrem a bibliotecas piratas, acertos de direitos autorais e trabalho humano extensivo para obter os volumes de dados necessários ao treinamento de IAs, devido à escassez de conteúdo de qualidade disponível publicamente.
O treinamento de IA depende de grandes volumes de dados de qualidade para que modelos como ChatGPT e Gemini aprendam a executar tarefas e interagir com usuários. Segundo o portal Canaltech, a dificuldade em encontrar conteúdo suficiente e confiável tem levado empresas de tecnologia a buscar fontes alternativas, incluindo obras protegidas por direitos autorais e trabalho humano intensivo.
Essa busca por dados não é apenas técnica, mas também envolve questões jurídicas e éticas. O processo de treinamento transforma informações brutas em padrões que as máquinas conseguem processar matematicamente. Sem dados robustos, a precisão, a segurança e a utilidade das ferramentas de inteligência artificial seriam comprometidas.
Como as empresas obtêm dados para treinar IAs
O abastecimento de modelos de IA vem de diversas fontes. Advogados especializados em tecnologia, citados pelo Canaltech, explicam que os dados podem originar-se da internet, bases públicas, livros, artigos científicos, parceiros comerciais e até das interações dos próprios usuários, quando permitido pelas regras do serviço.
O especialista Daniel Failla destaca que uma IA não aprende de forma neutra. "Ela aprende a partir do material que recebe e das escolhas feitas por quem a desenvolve", afirma. Isso significa que a seleção de fontes e o filtro de conteúdos influenciam diretamente os vieses e os erros que o modelo pode cometer.
As quatro frentes do treinamento
O processo de alimentação de dados é dividido em etapas específicas, conforme a análise de Diogo Coletta, sócio-fundador do Coletta Rodrigues Advogados:
- Pré-treinamento: coleta de grandes volumes de conteúdo na internet, como bases Common Crawl, Wikipédia, Reddit e jornais.
- Ajuste fino (fine-tuning): uso de conjuntos de dados específicos e selecionados, muitas vezes obtidos por acordos com agências de notícias e editoras.
- Alinhamento (RLHF): uso de feedback humano (Reinforcement Learning from Human Feedback), onde pessoas avaliam respostas e realizam testes de segurança.
- Dados dos usuários: prompts e conversas enviadas aos serviços, dependendo das configurações de privacidade de cada plataforma.
O uso de dados em primeira pessoa para robôs
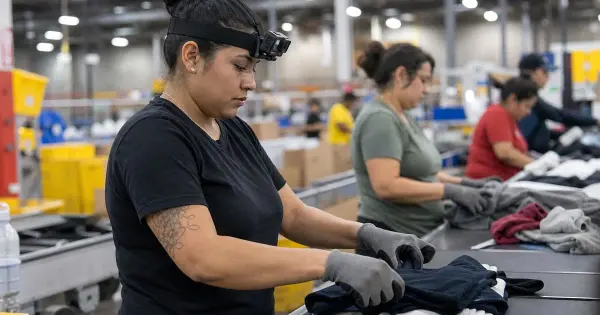
Quando o objetivo é criar robôs que atuam no mundo físico, a estratégia de coleta muda. Empresas utilizam dados em primeira pessoa, captados por câmeras, celulares ou óculos usados por trabalhadores durante tarefas cotidianas, como dobrar roupas ou lavar louça.
Empresas como Tesla, Figure AI e Agility Robotics investem nessa tecnologia. Startups como Micro1 e Objectways recrutam trabalhadores para gravar essas tarefas. A Scale AI, por exemplo, já reuniu mais de 100 mil horas desse tipo de material. Nesse cenário, o trabalhador atua como um "sensor humano", fornecendo os dados para ensinar a máquina a realizar a mesma função que ele executa.
Riscos de pirataria e direitos autorais
A escassez de conteúdo humano de alta qualidade tem motivado o uso de materiais protegidos por direitos autorais. O Canaltech relata casos recentes de disputas jurídicas envolvendo grandes empresas de tecnologia.
Um dos exemplos mais notáveis envolve a Anthropic, que baixou e armazenou mais de 482 mil livros obtidos de bibliotecas digitais piratas para treinar o modelo Claude. A empresa chegou a um acordo de US$ 1,5 bilhão, considerado o maior relacionado a direitos autorais na história dos Estados Unidos.
Outro caso é o processo Kadrey v. Meta Platforms, onde a Meta utilizou livros de autores como Sarah Silverman e Richard Kadrey, obtidos da biblioteca pirata LibGen, para treinar o LLaMA. Segundo Diogo Coletta, a empresa teria abandonado negociações de licenciamento legítimo após descobrir que a biblioteca pirata reunia os títulos desejados.
O papel do trabalho humano e a privacidade
Apesar da automação, o treinamento de IA ainda depende significativamente de pessoas. O Canaltech menciona os "trabalhadores fantasmas", responsáveis por classificar imagens, avaliar respostas e moderar conteúdos. Esse trabalho é essencial para o alinhamento dos modelos, mas levanta questões sobre as condições de trabalho e a exposição a conteúdos sensíveis.
Além disso, a coleta de dados em primeira pessoa para robôs pode registrar partes de residências, outras pessoas e informações do ambiente. Isso gera dúvidas sobre privacidade, armazenamento e o uso dessas gravações. Os usuários de assistentes virtuais também podem compartilhar informações sensíveis, como dados de saúde, sem perceber as implicações do uso desses dados no aprimoramento dos modelos.
Perguntas frequentes
Quanto custa treinar um modelo de IA?
Os custos variam, mas envolvem a aquisição de dados, energia computacional e mão de obra. Casos como o da Anthropic mostram que acordos de direitos autorais podem atingir valores bilionários, refletindo o valor estratégico dos dados de qualidade.
Os dados dos usuários são usados para treinar IAs?
Sim, dependendo das políticas de privacidade e configurações do serviço. Prompts, conversas e arquivos podem ser utilizados para aprimorar os modelos, o que exige atenção do usuário ao compartilhar informações sensíveis.
Qual o risco de usar bibliotecas piratas para treinar IAs?
O principal risco é jurídico. O uso de obras protegidas sem licenciamento pode resultar em processos judiciais e multas significativas, além de questionamentos éticos sobre a origem dos dados.